Еще недавно голосовое управление компьютером казалось технологией из научно-фантастических фильмов. Сегодня достаточно произнести команду смартфону, чтобы найти информацию, включить музыку, продиктовать сообщение или управлять устройствами умного дома. За этой привычной возможностью стоят нейронные сети — сложные математические модели, которые научились преобразовывать звуковые колебания в понятный человеку текст. Но как машина понимает, что именно произнес собеседник, если человеческая речь отличается скоростью, произношением, интонациями и даже наличием посторонних шумов?
Распознавание речи — это не простое сравнение звуков с заранее записанными образцами. Нейросеть анализирует акустические характеристики сигнала, выявляет закономерности в последовательностях звуков и определяет наиболее вероятный вариант произнесенной фразы. Для этого используются методы машинного обучения, обработки сигналов и статистического анализа языка.
Как голос превращается в цифровые данные?
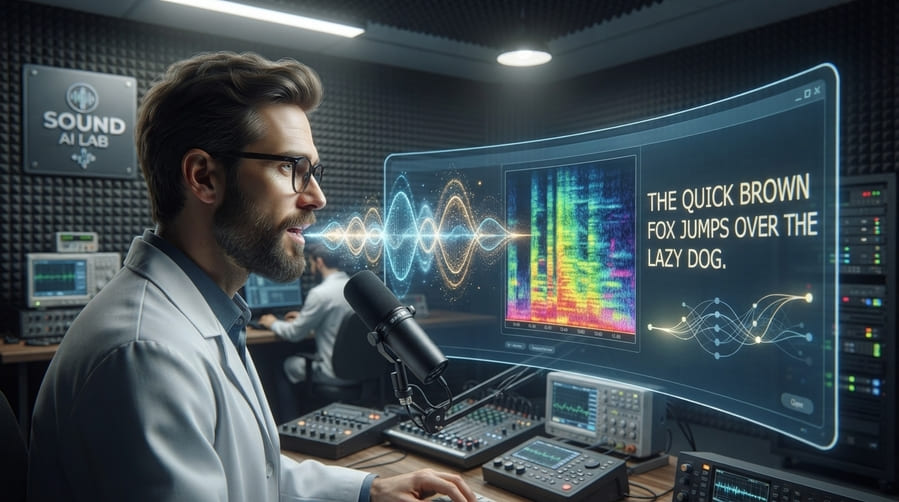
Первый этап распознавания начинается с микрофона. Он преобразует звуковые волны в электрический сигнал, который затем оцифровывается. Компьютер получает последовательность чисел, описывающих изменения звукового давления во времени. Например, при частоте дискретизации 16 кГц записывается 16 000 измерений сигнала каждую секунду.
Однако анализировать миллионы отдельных значений напрямую неудобно. Поэтому система разделяет аудиозапись на небольшие фрагменты, обычно продолжительностью несколько десятков миллисекунд, и вычисляет для них специальные признаки. Один из распространенных методов — преобразование Фурье, позволяющее представить звук через составляющие его частоты. В результате формируется спектрограмма — своеобразная карта звука, где видны изменения частот во времени.
По такой карте можно различать характерные особенности речи. Например, гласные звуки имеют выраженную структуру частотных составляющих, а согласные могут сопровождаться короткими шумовыми или взрывными компонентами. Нейросеть использует эти закономерности, чтобы определить, какие звуковые элементы присутствуют в записи.
Как нейросеть понимает отдельные слова?
После обработки аудиосигнала начинается собственно распознавание. Модель получает последовательность акустических признаков и пытается определить, какие речевые единицы им соответствуют. В зависимости от архитектуры это могут быть фонемы, слоги, части слов или непосредственно текстовые токены.
Раньше в системах распознавания часто применялись скрытые марковские модели и отдельные акустические, произносительные и языковые компоненты. Современные решения используют глубокие нейронные сети, в том числе трансформеры. Они способны учитывать контекст и взаимосвязи между элементами длинной последовательности.
Представим, что человек произносит фразу «поставь чайник». В звуковой записи нет пробелов между словами, а отдельные звуки могут сливаться. Нейросеть должна определить, где заканчивается одно слово и начинается другое. Кроме того, она учитывает, какие сочетания слов наиболее вероятны в русском языке. Благодаря этому система может правильно распознать фразу даже при нечетком произношении.
Почему контекст помогает распознавать речь?
Одна из главных сложностей человеческой речи заключается в неоднозначности. Одинаково или почти одинаково звучащие слова могут иметь разные значения. Например, слова «плод» и «плот» различаются всего одним согласным звуком, а в шумной записи это различие может быть практически незаметным.
Здесь помогает языковая модель. Она оценивает не только акустическое сходство, но и вероятность появления определенной последовательности слов в конкретном контексте. Если человек говорит «на столе лежит книга», система скорее выберет слово «книга», чем случайное созвучное сочетание.
Современные модели могут учитывать значительно более длинные фрагменты текста, чем простые системы предыдущих поколений. Благодаря этому распознавание становится точнее при сложных формулировках, разговорных выражениях и естественном темпе речи. Однако контекст иногда способен и навредить: если произношение нечеткое, алгоритм может подставить распространенное слово вместо редкого имени или специального термина.
Какие технологии используют для распознавания речи?
Одним из важных направлений стали модели типа Whisper, разработанные OpenAI. Они обучаются на больших массивах аудиоданных и умеют распознавать речь на разных языках, определять язык записи и выполнять перевод речи в текст. Архитектура таких систем основана на трансформерах, которые эффективно обрабатывают последовательности данных.
Другой подход используют современные потоковые системы распознавания. Они анализируют поступающий звук практически в реальном времени, не дожидаясь окончания всей фразы. Это особенно важно для голосовых помощников, телефонных сервисов и автоматических систем управления.
Существуют также модели с архитектурами CTC (Connectionist Temporal Classification) и RNN-T (Recurrent Neural Network Transducer). Они помогают сопоставлять последовательности акустических признаков с текстом и особенно полезны там, где требуется быстро выводить результат по мере поступления речи.
Где применяется распознавание человеческой речи?
Сегодня технологии распознавания речи используются в самых разных сферах. Они позволяют автоматизировать рутинные процессы, ускорять работу с информацией и сделать взаимодействие с электронными устройствами более естественным. Наиболее интересные примеры практического применения:
- Голосовые помощники. Siri, Google Assistant и Алиса преобразуют голосовые команды в действия: запускают приложения, ищут информацию и управляют устройствами.
- Автоматическая расшифровка аудио. Нейросети превращают записи интервью, лекций, совещаний и подкастов в текстовые документы.
- Медицинская документация. Врачи могут диктовать заключения и описания обследований, сокращая время ручного заполнения документов.
- Контактные центры. Системы анализируют телефонные разговоры, создают стенограммы и помогают находить повторяющиеся вопросы клиентов.
- Автомобильные мультимедийные системы. Водитель может голосом задавать маршрут, выбирать музыку и управлять отдельными функциями автомобиля.
- Автоматические субтитры. Распознавание речи позволяет создавать текстовое сопровождение видеороликов, вебинаров и онлайн-трансляций.
Практическая польза технологии зависит от качества микрофона, акустики помещения, языка, особенностей произношения и используемой модели. Например, запись в тихой комнате обычно распознается точнее, чем разговор на улице рядом с транспортом. Для повышения качества применяются шумоподавление, подавление эха и адаптация модели к конкретной терминологии.
Почему нейросети все еще ошибаются?
Несмотря на впечатляющие результаты, распознавание речи не стало безошибочным. Сложности возникают при сильном фоновом шуме, одновременной речи нескольких людей, редких фамилиях, диалектах и необычных сокращениях. Особенно непросто системам работать с профессиональной лексикой: медицинскими диагнозами, техническими обозначениями или названиями лекарств.
Еще одна проблема — пунктуация. В устной речи человек не произносит запятые и точки, поэтому алгоритм должен самостоятельно определить границы предложений и смысловых частей. Для этого он анализирует паузы, интонацию и языковой контекст.
В будущем системы распознавания будут все лучше объединять анализ речи, понимание смысла, определение говорящих и обработку эмоций. Но важно помнить: распознать произнесенные слова и действительно понять намерение человека — разные задачи. Нейросеть может достаточно точно записать фразу, но ошибиться в ее смысле. Именно поэтому голосовые технологии становятся эффективнее не только благодаря более мощным вычислениям, но и за счет совершенствования моделей, которые учитывают контекст общения.